RAG e segundo cérebro não são técnicas rivais. As duas existem para dar à IA um conhecimento que não está nos pesos do modelo, e cada uma cobre uma parte diferente do problema. O RAG, que já apareceu aqui no blog na metodologia do RAG for Humans, busca trechos parecidos com a pergunta em um índice vetorial. O segundo cérebro mantém uma base de páginas ligadas entre si, mas o agente não lê a wiki inteira de uma vez: ele abre primeiro o catálogo index.md, filtra apenas as páginas relevantes e lê essas páginas por completo, em vez de receber fragmentos soltos. Quem usa só uma das abordagens passa boa parte do tempo contornando a limitação dela. A saída prática é combinar as duas, e o padrão que popularizou o segundo cérebro para IA termina recomendando busca quando a base cresce.
Em vez de responder só com o que aprendeu no treinamento, o modelo recebe um contexto montado na hora. A diferença está em como esse contexto é montado: por similaridade matemática entre fragmentos ou por navegação em uma estrutura de páginas escritas para serem lidas por inteiro, começando pelo índice.
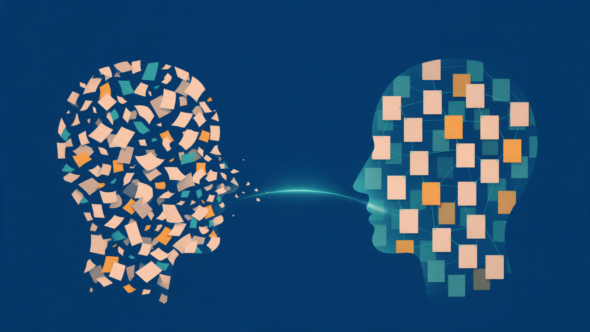
RAG vs segundo cérebro: como cada um monta o contexto
O RAG foi descrito em 2020 por Patrick Lewis e outros pesquisadores da Facebook AI Research, da University College London e da New York University. O artigo original propõe combinar memória paramétrica, o que está dentro do modelo, com memória não paramétrica, um índice vetorial consultado por um recuperador neural. Na prática, o sistema corta os documentos em pedaços, converte cada pedaço em vetor e guarda tudo em um banco vetorial. Quando chega uma pergunta, ele calcula a proximidade entre a pergunta e os pedaços, pega os mais próximos e entrega ao modelo.
O segundo cérebro nasceu como método humano. Tiago Forte descreve a prática em seu guia introdutório como um repositório digital externo para o que a pessoa aprende, com ideias e fontes guardadas de forma recuperável. A versão para IA ganhou forma em abril de 2026, quando Andrej Karpathy publicou o padrão LLM Wiki. Ali, o modelo não indexa arquivos brutos: ele lê cada fonte e mantém uma wiki de arquivos Markdown, com páginas de entidades, conceitos, comparações e um índice. As fontes originais ficam intocadas. Um arquivo de esquema, como CLAUDE.md ou AGENTS.md, define as convenções da wiki, e o modelo segue essas regras ao ingerir material, responder e revisar.
Duas convenções de arquivo sustentam a navegação. O index.md é o catálogo de conteúdo: lista cada página com link, resumo de uma linha e, opcionalmente, data ou número de fontes, organizado por categoria. O log.md é o registro cronológico append-only das ingestões, consultas e revisões, com prefixo fixo em cada entrada, o que permite pesquisar o histórico com ferramentas Unix comuns, como grep e tail.
O padrão define três operações. No Ingest, o modelo lê a fonte nova, escreve a página de resumo, atualiza o índice, revisa as páginas de entidade e conceito afetadas e acrescenta a entrada no log, movimento que pode tocar de 10 a 15 páginas por fonte. No Query, ele procura as páginas relevantes, lê e responde com citações, e as boas respostas voltam para a wiki como páginas novas, de modo que a análise também se acumula. No Lint, ele audita a base em busca de contradições, afirmações superadas por fontes mais recentes, páginas órfãs, links quebrados e conceitos citados sem página própria, e ainda sugere o que investigar em seguida.
A wiki é editável em qualquer editor de texto. O Obsidian, por exemplo, guarda as notas como arquivos Markdown de texto puro dentro de uma pasta, o que deixa o conteúdo auditável fora de qualquer aplicação.
O ponto cego do RAG
Busca por similaridade funciona bem quando a resposta está em um trecho. Ela falha quando a resposta depende de juntar informação espalhada. A Microsoft descreve esse limite ao justificar o GraphRAG: o RAG de linha de base tem dificuldade para conectar pontos e para resumir conceitos de forma holística em coleções grandes. A resposta da empresa foi extrair um grafo de conhecimento do corpus, assunto que já foi tratado aqui no artigo sobre GraphRAG.
O ponto cego mais sério, porém, aparece na atualização. Quando uma informação muda, o banco vetorial costuma manter o trecho antigo ao lado do novo, e a busca pode devolver os dois em conflito, sem que o modelo saiba qual vale. A wiki resolve a contradição na hora da ingestão: a síntese é reescrita e o dado superado fica sinalizado. Em compensação, inserir documento em banco vetorial é barato. A inserção é incremental, entra só o documento novo ou editado, sem reprocessar a coleção inteira, e gerar embeddings custa menos que o ingest da wiki, que aciona o LLM para reescrever de 10 a 15 páginas a cada fonte.
Há ainda o efeito do tamanho do contexto. O contexto entregue ao modelo é sempre uma amostra, e quanto mais tokens entram na janela, mais ele perde precisão para recuperar o que está lá dentro. O fenômeno foi batizado de context rot pela Chroma Research, em estudo de julho de 2025 que avaliou 18 modelos. A Anthropic adota o termo no guia sobre engenharia de contexto para agentes, de setembro de 2025, e cita o trabalho da Chroma.
Onde o segundo cérebro tropeça
A wiki resolve a visão parcial, mas cria outro problema: alguém precisa mantê-la. O padrão de Karpathy aposta que o modelo faz esse trabalho, porque atualizar referências e resumos é chato para humanos e barato para LLM. O humano fica com a curadoria das fontes, a definição do esquema e as perguntas.
A ideia tem linhagem. Karpathy lembra que o Memex, proposto por Vannevar Bush em 1945, já imaginava um acervo pessoal privado, curado à mão, com trilhas associativas entre documentos, em que as conexões valiam tanto quanto o material guardado. O que Bush não resolveu foi quem faz a manutenção. É essa parte que o LLM assume agora.
A escala cobra a conta. O próprio texto diz que o index.md funciona bem em torno de 100 fontes e algumas centenas de páginas sem infraestrutura de embeddings. Acima disso, ele recomenda uma ferramenta de busca e cita o qmd, sigla de Query Markup Documents, criado por Tobi Lütke. O qmd roda 100% no próprio dispositivo, combina índice SQLite FTS5, busca vetorial e reordenação por modelos GGUF locais, e expõe tanto uma CLI quanto um servidor MCP, para o agente consultar a wiki sem depender de nuvem. A wiki madura volta a precisar de recuperação.
RAG e segundo cérebro juntos
A divisão que funciona segue o tipo de pergunta. Acervo bruto e volumoso, como contratos, históricos de atendimento e arquivos que ninguém organizou, pede recuperação por similaridade. Conhecimento que se acumula e precisa de síntese, como regras de operação, decisões de projeto e comparações, pede páginas estruturadas e ligadas.
Na operação, os dois viram um pipeline. A ingestão de uma fonte atualiza as páginas da wiki e, ao mesmo tempo, alimenta o índice vetorial do acervo cru. A busca híbrida, que soma palavra-chave e vetor, navega as páginas e, quando o assunto ainda não tem página, cai no material original. O índice da wiki orienta o modelo sobre onde procurar; o RAG garante que ele não fique limitado ao que já foi resumido.
Contexto melhor não transforma o modelo em decisor. Quando a tarefa é escolher uma categoria dentro de um conjunto fechado, o que se pede é uma decisão estruturada, como no caso do System One, e não uma síntese de páginas.
Uma base só de RAG responde bem o que está escrito e mal o que precisa ser entendido em conjunto. Uma base só de wiki explica o que já foi consolidado e trava no que ainda está espalhado. Manter as duas camadas custa menos do que escolher uma e passar o resto do tempo contornando o que ela não faz.
Fontes: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (arXiv), Andrej Karpathy: LLM Wiki, Chroma Research: Context Rot, qmd: Query Markup Documents, Obsidian Help: How Obsidian stores data, Forte Labs: Building a Second Brain, Anthropic: Effective context engineering for AI agents, Microsoft: GraphRAG.