A NVIDIA publicou em janeiro de 2026 o PersonaPlex, um modelo de voz que escuta e fala ao mesmo tempo e assume o papel descrito em um prompt de texto. No checkpoint que está no Hugging Face, a troca de turno leva 0,170 segundo e acerta 90,8% das vezes, contra 1,3 segundo do Gemini Live. O diferencial é separar a persona em dois canais, texto e áudio. O código está sob licença MIT e os pesos, sob a NVIDIA Open Model License.
Para baixar os pesos é preciso aceitar os termos no Hugging Face e usar um token, porque o acesso é restrito. Quem só quer conversar com a persona pode usar a demonstração no site da NVIDIA. Os números do protótipo descrito no artigo não são os mesmos do modelo liberado, e os dois conjuntos aparecem separados ao longo do texto.
O que é o PersonaPlex
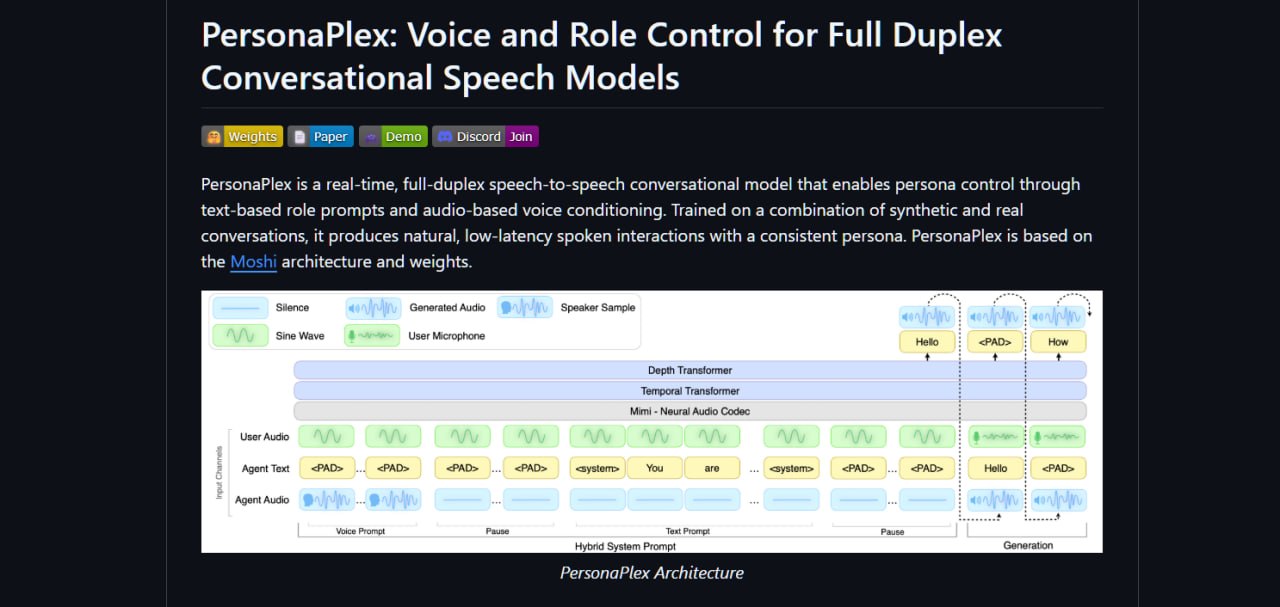
PersonaPlex é um modelo de 7 bilhões de parâmetros que recebe áudio e devolve áudio, sem passar pelas três etapas separadas de reconhecimento de fala, modelo de linguagem e síntese. A base é o Moshi, modelo da francesa Kyutai licenciado em CC-BY-4.0, que já fazia conversa em tempo real mas travava o assistente em uma única voz e um único papel. A NVIDIA manteve a arquitetura e acrescentou o controle de persona.
No GitHub, o repositório somava 12.040 estrelas e 1.626 forks em 4 de novembro de 2026, com 73 issues abertas e nenhuma release ou tag publicada. O último envio de código registrado é de 2 de março de 2026. No Hugging Face, os pesos acumulavam 152.472 downloads e 2.948 curtidas na mesma data. Estrela mede interesse, não manutenção nem estabilidade.
Nas tabelas do artigo, o protótipo marca 3,90 de naturalidade de diálogo no Full-Duplex-Bench e 3,59 no Service-Duplex-Bench, contra 3,72 e 3,22 do Gemini Live, 3,11 e 2,83 do Moshi. A similaridade de locutor, medida por cosseno com o modelo de verificação de falante WavLM-TDNN, fica em 0,57, contra 0,00 do Gemini Live e 0,10 do Moshi.
O resultado não é uniforme. No Service-Duplex-Bench, criado pelos próprios autores, o Gemini Live lidera a aderência às instruções da tarefa na avaliação do GPT-4o, com média 4,73 contra 4,48 do PersonaPlex. Na naturalidade julgada por humanos no mesmo conjunto, a ordem se inverte: 3,59 do PersonaPlex contra 3,22 do Gemini Live.
Tecnologia: papel no texto e voz na amostra
O modelo recebe dois sinais. O primeiro é o prompt de papel, um texto curto com nome, empresa, informações do serviço e tom de atendimento, como o exemplo de uma empresa de coleta de lixo no repositório. O segundo é o voice prompt, um trecho de áudio convertido em embedding que carrega timbre, estilo e prosódia. Os dois entram juntos, e o resultado é um personagem que mantém voz e comportamento ao longo da conversa.
O arranjo interno do prompt híbrido tem um detalhe de engenharia. O artigo diz que a posição dos dois trechos não muda o desempenho, mas o prompt de voz vem antes do prompt de texto na implementação: assim a voz pode ser pré-carregada em cache (prefilling) quando não é preciso clonar um locutor novo, o que reduz a latência. Durante a leitura do prompt, o canal do usuário é preenchido com uma onda senoidal de 440 Hz para estabilizar a condição, e delimitadores de texto e áudio marcam onde acaba o prompt e começa o diálogo.
Os componentes vêm do Moshi. O áudio de 24 kHz é comprimido pelo codec neural Mimi em 12,5 quadros por segundo, ou seja, um quadro a cada 80 milissegundos, com codificador convolucional e um transformer. O transformer temporal parte do Helium, um modelo de linguagem de 7 bilhões de parâmetros, e um segundo transformer, o de profundidade, gera os múltiplos tokens de áudio de cada quadro. É essa divisão que permite falar e ouvir no mesmo instante.
Nas métricas de conversa, os dois checkpoints divergem. O protótipo da tabela 2 troca de turno em 0,07 segundo, com 99,2% de acerto, e leva 0,400 segundo para reagir a uma interrupção. O modelo liberado, na tabela 6, chega a 0,170 segundo de troca de turno com 90,8% de acerto e 0,240 segundo de interrupção, com similaridade de voz em 0,65, acima dos 0,57 do protótipo. Ou seja: o checkpoint público é mais rápido na interrupção e clona melhor a voz, mas cede na taxa de troca de turno.
O treinamento misturou dados reais e sintéticos: 7.303 conversas do Fisher English Corpus, 1.217 horas no total, mais 39.322 diálogos sintéticos de assistente e 105.410 de atendimento ao cliente. As transcrições saíram do Qwen3-32B e do GPT-OSS-120B, e a fala foi gerada com o Chatterbox, da Resemble AI, além de vozes sintéticas do TortoiseTTS. Foram seis horas de treino em oito GPUs A100, segundo o The Decoder.
Recursos já existentes
O conjunto de vozes prontas é o recurso mais visível: oito embeddings classificados como naturais, de NATF0 a NATF3 e de NATM0 a NATM3, e dez de variedade, de VARF0 a VARF4 e de VARM0 a VARM4, todos rotulados no repositório.
- Papel definido por texto, com exemplos de banco, consultório médico, restaurante e locadora de drones no README
- Condicionamento de voz por amostra de áudio, usado para manter timbre e sotaque
- Tratamento de interrupção, backchannel e pausa
- Servidor local com interface web em localhost:8998 para conversa ao vivo
- Modo offline que recebe um arquivo WAV e devolve outro WAV com a transcrição
- Flag –cpu-offload, para mover camadas do modelo para a CPU quando a memória de vídeo não basta
O que está por vir
Os autores citam dois próximos passos: alinhamento pós-treino e integração com ferramentas. Também anunciaram o ServiceDuplexBench, extensão do FullDuplexBench com 350 perguntas de atendimento em 50 cenários. A página do projeto diz que o benchmark seria liberado em breve; até 4 de novembro de 2026, o repositório não traz release, tag nem arquivo do benchmark.
Principais dúvidas sobre o projeto
É gratuito? O código é MIT, o que permite uso, modificação e redistribuição. Os pesos seguem a NVIDIA Open Model License, que autoriza uso comercial dentro dos termos da licença, e o download exige login e aceite no Hugging Face. A base Moshi é CC-BY-4.0, da Kyutai.
Precisa de GPU? Sim. O README pede a biblioteca Opus e GPU NVIDIA com CUDA, e cita o pacote do PyTorch compilado para Blackwell. O repositório não fixa um piso de memória de vídeo. Só os pesos de 7 bilhões de parâmetros em BF16 ocupam cerca de 14 GB, relatos de terceiros apontam 15 a 16 GB em execução direta e guias derivados do próprio projeto recomendam 24 GB. Para placas menores existe a flag de offload, que exige instalar o pacote accelerate à parte, com pip install accelerate. Também há versões quantizadas feitas por terceiros, que não são da NVIDIA.
Fala português? Não. O modelo foi treinado e avaliado em inglês, e a documentação só cita esse idioma. Para transcrever áudio em português rodando na máquina local, o Tambotech já mostrou o Meetily.
Como os números do artigo foram medidos? A naturalidade saiu de um índice de opinião (DMOS) com 354 avaliadores recrutados no Amazon Mechanical Turk, somando 202 pessoas no Service-Duplex-Bench e 152 no Full-Duplex-Bench. A similaridade de voz é a similaridade de cosseno entre o embedding do prompt enviado e o da fala gerada, medida com o WavLM-TDNN. O GPT-4o entrou apenas como juiz da aderência às instruções, não da naturalidade nem da semelhança de voz.
Já foi testado por terceiros? Sim. Em 2 de novembro de 2026 o InteractionBench (arXiv:2611.02430) avaliou o nvidia/personaplex-7b-v1 ao vivo, com 221 itens por sistema em treze cenários. O modelo da NVIDIA acertou 9 de 50 tarefas faladas, 18%, contra 68% do GPT-Live, 70% do GPT-Realtime e 72% do Gemini Live; uma cascata tradicional chegou a 76%. Nas sondagens de coerência em conversas longas, os sistemas hospedados passaram em 67% a 88% dos testes, contra 30% do PersonaPlex.
O que existe hoje é um modelo de pesquisa com código aberto e 7 bilhões de parâmetros, publicado em janeiro de 2026 e sem atualização de código desde março. O passo que os autores apontam como próximo é o alinhamento pós-treino e a integração com ferramentas. Os identificadores para consulta técnica são arXiv:2602.06053, o repositório NVIDIA/personaplex no GitHub e o pacote nvidia/personaplex-7b-v1 no Hugging Face.
Fonte: NVIDIA ADLR