O GLM 5.2, modelo de linguagem da chinesa Z.ai (ex-Zhipu AI), foi anunciado nesta semana com uma constatação que viralizou nas redes: ele supera o Claude Opus 4.7 em diversos benchmarks e, em testes cegos, chega a ultrapassar o Claude Fable 5, o modelo mais avançado da Anthropic. Mas será que essa afirmação faz sentido no cenário atual de IA?
A história ganhou contornos geopolíticos: na mesma semana em que os Estados Unidos bloquearam o acesso ao Fable 5, a China lança um modelo open source que, segundo os vídeos virais, “roda localmente no seu computador” e “destrona a tecnologia americana”. O roteiro é perfeito para gerar cliques, mas a realidade é mais interessante do que o hype.
O que dizem os números
A Z.ai é a empresa chinesa por trás da família de modelos GLM. Antiga Zhipu AI (Beijing Zhipu Huazhang Technology), a empresa tem entre 500 e 1.000 funcionários e é uma das principais desenvolvedoras de IA do país, com investimentos de gigantes como Alibaba, Tencent e Xiaomi. Aleém do GLM 5.2, seus produtos incluem o ChatGLM (similar ao ChatGPT), AutoGLM (agentes autônomos), CodeGeeX (assistente de codificação) e AMiner (plataforma de pesquisa acadêmica). A empresa abriu capital na Bolsa de Hong Kong (02513.HK) e é reconhecida como um dos “tigres” da inteligência artificial chinesa.
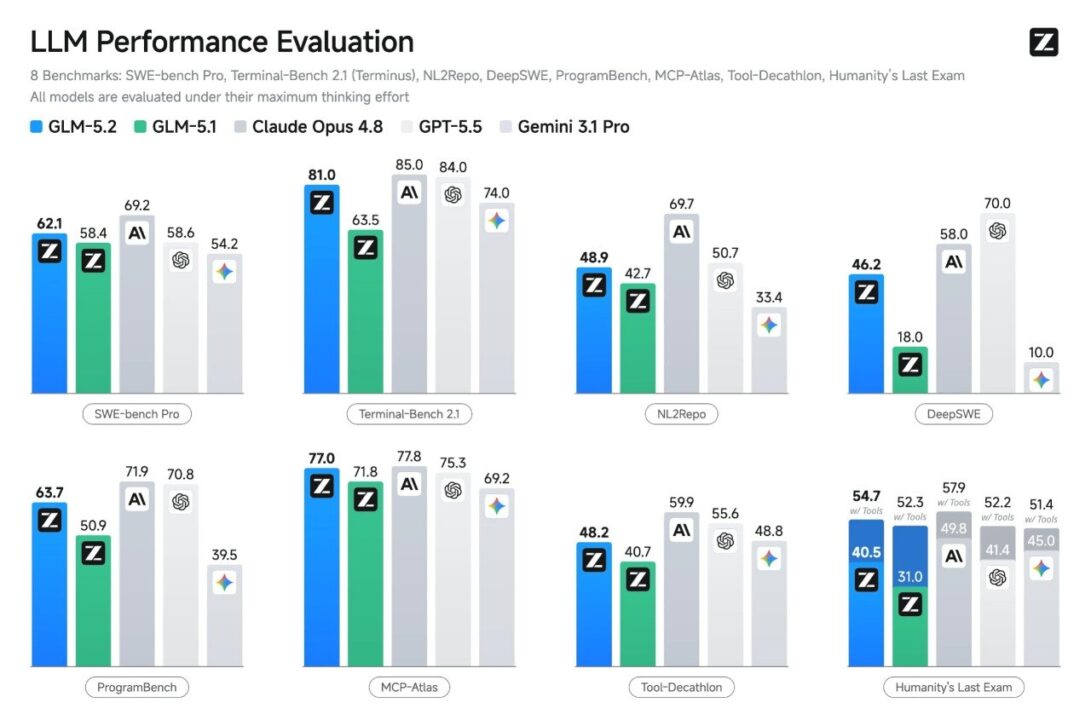
Fato é que o GLM 5.2 tem números impressionantes. No BenchLM, ele marca 94 contra 84 do Claude Opus 4.7 Adaptive, uma diferença de 10 pontos no agregado. No Arena (antigo LMArena), ficou em segundo lugar mundial em coding, superando Claude Opus 4.7 e 4.8. No Design Arena, chegou ao primeiro lugar, ficando à frente até do Claude Fable 5.
Seu contexto de 1 milhão de tokens e licença MIT são atrativos reais para empresas que querem controle sobre o modelo. O anúncio oficial está em z.ai/blog/glm-5.2. A comparação de preços também chama atenção: o GLM 5.2 custa US$ 1,40 por milhão de tokens de entrada e US$ 4,40 de saída, contra US$ 5 e US$ 25 do Claude Opus 4.7 Adaptive, uma diferença de 5,7x no custo de saída.
O detalhe é que o GLM 5.2 leva vantagem principalmente em tarefas agentic (81 contra 74,9 no BenchLM), enquanto o Claude ainda ganha em coding puro (72,9 contra 62,1) e conhecimento (68,2 contra 67,2). A história de “superou” é mais matizada do que os títulos sugerem.
“Roda localmente” — aí o bicho pega
A viralização do GLM 5.2 veio acompanhada de uma frase mágica: “roda localmente, é gratuito e open source”. A realidade é bem mais complexa. O modelo tem 753 bilhões de parâmetros e exige cerca de 900 GB de VRAM para rodar com desempenho útil. Isso significa servidores com múltiplas H100 ou H200, um investimento de centenas de milhares de reais.
Como bem observou o perfil @ismktmidia no Instagram, “dizer que o GLM 5.2 roda localmente é o equivalente a dizer que você pode guardar um Boeing 777 na garagem de casa só porque a Boeing liberou o manual de instruções na internet”. O influenciador que empurra o “roda no seu PC” vende cliques, não realidade. O modelo é open source sim (MIT), mas o gap entre ter o código e executá-lo com desempenho útil é onde a desonestidade intelectual costuma operar.
A velocidade do mercado torna essa pergunta obsoleta
A questão “quem superou quem” perde relevância a cada semana que passa. No último mês, OpenAI lançou o GPT-5.5, Anthropic soltou Claude Opus 4.7 e 4.8, Google anunciou o Gemini 3.5 Flash, DeepSeek dropou o V4 Pro com licença MIT, Alibaba lançou o Qwen 3.7 Max, e agora Z.ai anuncia o GLM 5.2. O ciclo é tão rápido que um modelo que lidera o ranking hoje pode estar em quinto lugar na semana que vem.
Nesse cenário, a busca pelo “melhor modelo” vira uma perseguição ao vento. O que separa quem entrega resultado de quem apenas acompanha o hype não é o modelo escolhido, mas sim a estrutura ao redor dele.
O que realmente importa
Mais importante do que o modelo são três coisas: o pipeline de uso, a qualidade dos dados e a capacidade de integrar a IA num fluxo de trabalho real. Um exemplo prático é o ecossistema Hermes Agent, que orquestra múltiplos agentes de IA (Zorro, Claudio Vago, Allan Vago) com skills especializadas, pipelines de publicação, watchdog de sistema e integração com WordPress, Telegram e outros serviços. O que faz a diferença não é qual LLM está rodando internamente, mas como as ferramentas se conectam, como os dados fluem e como o sistema se mantém operacional sem intervenção constante.
O mesmo vale para qualquer aplicação de IA em produção: a dureza do trabalho está em orquestrar, validar, iterar e manter, não em escolher qual modelo está no topo do ranking está semana. Enquanto a indústria se distrai com rankings, quem realmente constrói sabe que o valor está na arquitetura, não no número do benchmark.